
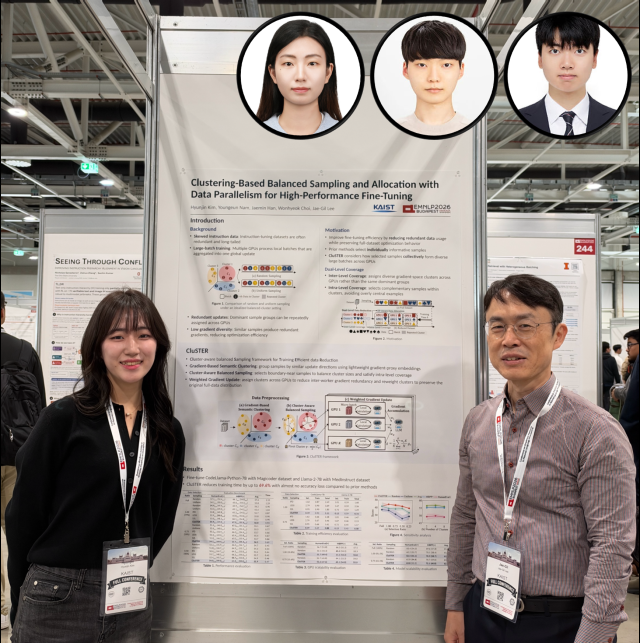
카이스트(KAIST) 연구진이 AI에 의료·코딩 등 특정 분야를 가르치는 추가 학습 시간을 최대 69.6% 줄이는 기술을 개발했다. 학습 효과가 비슷한 자료는 덜어내고 서로 다른 자료를 여러 GPU에 고르게 나눠 처리해, 10시간 걸리던 학습을 약 3시간 만에 끝낼 수 있는 수준이다.
카이스트는 전산학부 이재길 교수 연구팀이 학습에 비슷한 영향을 주는 데이터를 묶어 선별하고 여러 GPU에 골고루 배분하는 대규모 언어모델 미세조정 기술 ‘클러스터(CluSTER)’를 개발했다고 2일 밝혔다.
미세조정은 폭넓은 지식을 갖춘 AI에 코딩 문제와 풀이, 의료 분야 질문과 답변 등을 추가로 학습시켜 해당 분야에 특화하는 과정이다.이 과정에는 계산량이 많아 여러 GPU가 학습 자료를 나눠 처리한다. GPU는 AI 학습에 필요한 계산을 빠르게 수행하는 반도체다. 자료를 무작위로 나누면 학습 효과가 비슷한 데이터를 여러 GPU가 반복해서 처리하게 된다. 이미 푼 문제와 비슷한 문제만 계속 푸는 것처럼 계산량에 비해 추가로 얻는 학습 효과가 작아진다.
이후 각 묶음에서 데이터를 선별하고, 여러 GPU가 다양한 학습 정보를 골고루 처리하도록 배분한다. 문제집에서 비슷한 문제는 줄이되 꼭 익혀야 할 여러 유형의 문제는 빠짐없이 남겨 나눠 푸는 방식이다. 데이터 양을 줄이는 데 그치지 않고, 선택한 데이터를 여러 GPU가 효율적으로 활용하도록 한 것이 특징이다.
연구팀은 코딩·의료 분야 학습 데이터 3종으로 매개변수 약 70억 개와 130억 개 규모의 대규모 언어모델을 미세조정하고, 총 8개 성능 평가 시험으로 효과를 확인했다. 매개변수는 AI가 학습하면서 조정하는 내부 수치로, 학습한 지식을 답변에 반영하는 데 쓰인다. 전체 데이터의 약 31%만 골라 학습했는데도 모델 성능은 거의 유지됐고, 학습 시간은 최대 69.6% 줄었다. 실험은 GPU 4개 환경을 중심으로 진행했으며, GPU 8개 환경에서도 기존 방식보다 우수한 성능을 보였다.
GPU를 더 투입하지 않고도 학습 자료를 잘 고르고 배분하는 것만으로 AI 학습 효율을 높일 수 있음을 보인 결과다. 기업이나 연구기관이 고객 상담, 코딩 지원, 의료 질의응답 등 특정 목적의 AI를 개발할 때 추가 학습에 드는 시간과 GPU 사용 비용을 줄일 수 있다는 것이 연구팀의 설명이다.
이재길 교수는 “AI 학습의 효율을 높이기 위해서는 GPU를 더 많이 사용하는 것뿐 아니라 어떤 데이터를 학습할지 똑똑하게 선택하는 것도 중요하다”며 "이번 연구는 기존 GPU 자원을 더 효율적으로 활용해 대규모 AI 모델의 학습 부담을 줄일 수 있다는 점에서 의미가 있다"고 말했다.
김성현 기자minus1@ajunews.com
기자의 다른기사
©'5개국어 글로벌 경제신문' 아주경제. 무단전재·재배포 금지






