
엔비디아가 한국어를 세계 인공지능(AI) 학습 기술 개발의 출발점으로 삼았다. 한국어 데이터를 생성하고 학습하는 기술을 확보한 뒤 이를 다른 국가와 언어로 확장하겠다는 구상이다. 세계적인 기술 경쟁력을 확보한 한국을 발판으로 글로벌 AI 생태계에서 영향력을 넓히려는 행보로 풀이된다. 다만 한국어 연구를 통해 엔비디아가 얻을 구체적인 사업적 이익에 대해서는 개방형 AI 생태계 조성이라는 원론적인 설명을 내놨다.
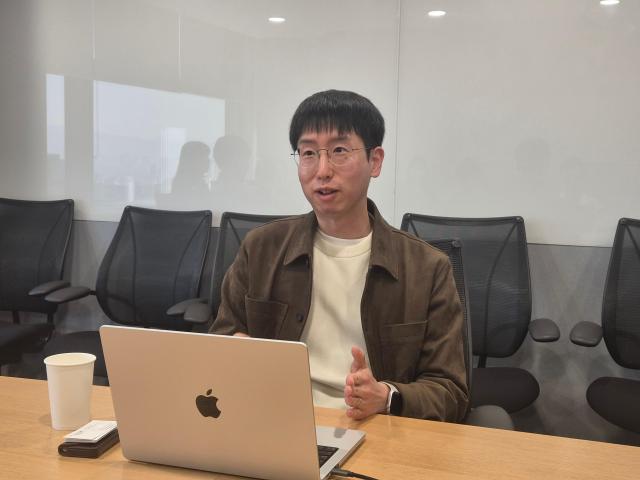
김현우 엔비디아 리서치 매니저 겸 엔비디아·한국과학기술원(KAIST) 공동 AI 연구소장은 10일 서울 강남구 엔비디아코리아 사무실에서 열린 기자간담회에서 "카이스트가 세계에서 굉장히 주목하는 학교가 됐기 때문"이라며 한국에 공동연구소를 설립한 배경을 설명했다.
김 소장은 "카이스트의 뛰어난 연구 성과와 우리말이 중간 자원 언어라는 독특한 위치가 맞물렸다"며 "한국인들의 높은 AI 관심까지 더해져 황금 같은 기회가 만들어졌다"고 평가했다.
엔비디아가 주목한 한국어의 가치는 세계 AI 시장으로 확장할 수 있는 연구 기반이라는 점이다. 한국어는 영어·중국어처럼 학습 자원이 풍부하지는 않지만 소수 언어보다는 데이터가 많은 '중간 자원 언어(Mid-resource language)'에 해당한다. 새로운 데이터 학습 기술을 개발하고 검증하기에 유리한 조건이라는 설명이다.
김 소장은 "우리말에서 시작해 다른 언어에도 적용할 수 있는 데이터 학습 방법을 공개하는 것이 목표"라며 "좋은 나무 한 그루를 만드는 것이 아니라 숲을 만드는 법을 연구해 세계에 나누려 한다"고 말했다.
한국어 연구가 엔비디아의 사업에 어떤 이익을 가져오는지에 대한 질문에는 구체적인 수익 모델을 제시하지 않았다. 그는 "회사 차원에서는 오픈된 AI 생태계를 꿈꾼다"며 "우리말을 시작으로 전 세계가 쓸 수 있는 방법론을 연구해 각 나라가 자기 언어의 AI를 만들도록 하는 것이 목표"라고 답했다.
엔비디아와 KAIST가 지난 7월 설립을 발표한 공동연구소는 엔비디아가 아시아에서 대학과 설립하는 첫 공동 AI 연구소다. 양측은 향후 5년간 총 3억달러(약 4000억원) 규모의 협력을 추진한다. 이 가운데 2억5000만달러는 컴퓨팅 자원으로 지원하며 나머지 재원의 구체적인 운용 방식은 논의 중이다.
김 소장은 "세계적인 AI 빅테크가 우리나라에 연구소를 설립하고 연구진을 채용하기 시작했다는 점에서 의미가 있다"며 "한국 연구진의 뛰어난 역량을 보여줘 더 많은 글로벌 기업이 국내에 연구소를 세우도록 하고 싶다"고 말했다.
다른 대학으로 협력이 확대될 가능성도 열어뒀다. 그는 "저희가 잘해서 그걸 열고 싶은 게 목표"라며 "꼭 엔비디아에 국한될 필요는 없다. 다른 회사들도 한국의 역량을 보고 들어올 수 있을 것"이라고 밝혔다.
서울대학교와의 협력과는 성격이 다르다고 설명했다. 엔비디아가 서울대와 추진 중인 AI 기술센터(NVAITC)는 공동연구와 교육 중심이다. 반면 KAIST 공동연구소에는 엔비디아 정규직 연구원을 직접 채용하고 컴퓨팅 자원을 지원한다.
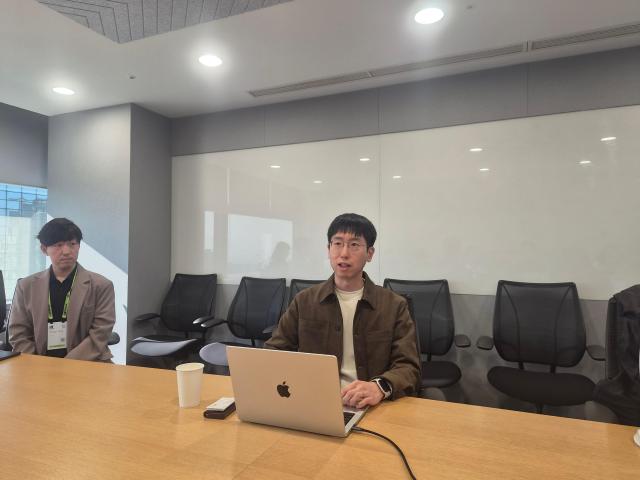
연구소 운영은 아직 초기 단계다. 김 소장은 "연구자 채용을 시작했으며 연내 몇 명을 채용할 계획"이라고 말했다. 국내 엔비디아 클라우드 파트너들과 GPU 자원 확보를 협의 중이며 구체적인 장비 수량은 확정되지 않았다.
최근 엔비디아의 리더십 문제와 관련해 최고경영자(CEO)가 교체되더라도 연구소 운영이 지속될 수 있느냐는 질문도 나왔다. 김 소장은 "그 부분에 대해 말씀드릴 적임자는 아닌 것 같다"면서도 "연구소장으로서 주어진 임무를 차질 없이 완수하는 것이 목표"라고 답했다.
공동연구소의 핵심 과제는 한국어 학습 데이터 부족을 해결하는 것이다. 발표 자료에 따르면 다국어 학습 데이터셋인 mC4에서 한국어 문서는 약 2400만건으로 영어 39억3000만건의 163분의 1 수준이다.
김 소장은 "양질의 우리말 공개 데이터셋을 찾기가 정말 어렵다"며 "특정 분야가 아니라 전 분야에 걸쳐 부족하다"고 지적했다. 이어 "사람이 생성하는 데이터만으로는 격차를 좁히기 어렵다"며 합성 데이터 생성과 기존 데이터를 효율적으로 학습하는 기술을 연구하겠다고 설명했다.
성과도 나타나고 있다. 김 소장이 앞서 공개한 한국어 합성 데이터셋 '네모트론 페르소나 코리아'는 허깅페이스에서 열흘간 전 세계 인기 데이터셋 1위를 기록했다. 다운로드 수도 약 14만회를 기록했다.
국내 기업의 활용 사례도 나왔다. 김 소장은 "LG AI연구원이 전날 공개한 'K-엑사원 2.5'에 해당 데이터셋이 활용됐다"며 "서로의 성과를 활용해 더 나은 모델을 만드는 생태계의 선순환 사례"라고 평가했다.
합성 데이터 활용에 따른 저작권 문제도 연구 과제로 꼽힌다. 김 소장은 기존 AI 모델이 어떤 방식으로 원본 데이터를 확보했는지는 알 수 없다고 설명했다. 연구소는 이미 학습된 모델의 지식을 활용해 새로운 데이터를 생성하는 방식에 집중할 계획이다.
연구 결과물은 특정 기업이 독점하지 않도록 공개하는 방향을 추진한다. 김 소장은 "네모트론 페르소나 데이터셋도 상업적으로 이용할 수 있도록 공개했다"며 다른 기업들도 활용할 수 있는 데이터와 학습 방법을 개발하겠다고 밝혔다.
첫 연구 성과 공개 시점은 내년 하반기로 예상했다. 김 소장은 "재미있는 프로젝트들이 준비돼 있어 내년 하반기쯤 공개될 수 있을 것"이라며 "우리나라에서 시작한 연구가 세계 AI 생태계에 기여하도록 하겠다"고 말했다.
조성준 기자critic@ajunews.com
기자의 다른기사
©'5개국어 글로벌 경제신문' 아주경제. 무단전재·재배포 금지






